Thinking Machines lanza Inkling, modelo de IA multimodal
Thinking Machines publica Inkling en Hugging Face, un modelo abierto que entiende texto, imágenes y audio y admite hasta 1 millón de tokens de contexto. Tiene 975.000 millones de parámetros, pero exige cientos de gigabytes de memoria para ejecutarse, por lo que su uso estará orientado sobre todo a servidores y versiones cuantizadas.
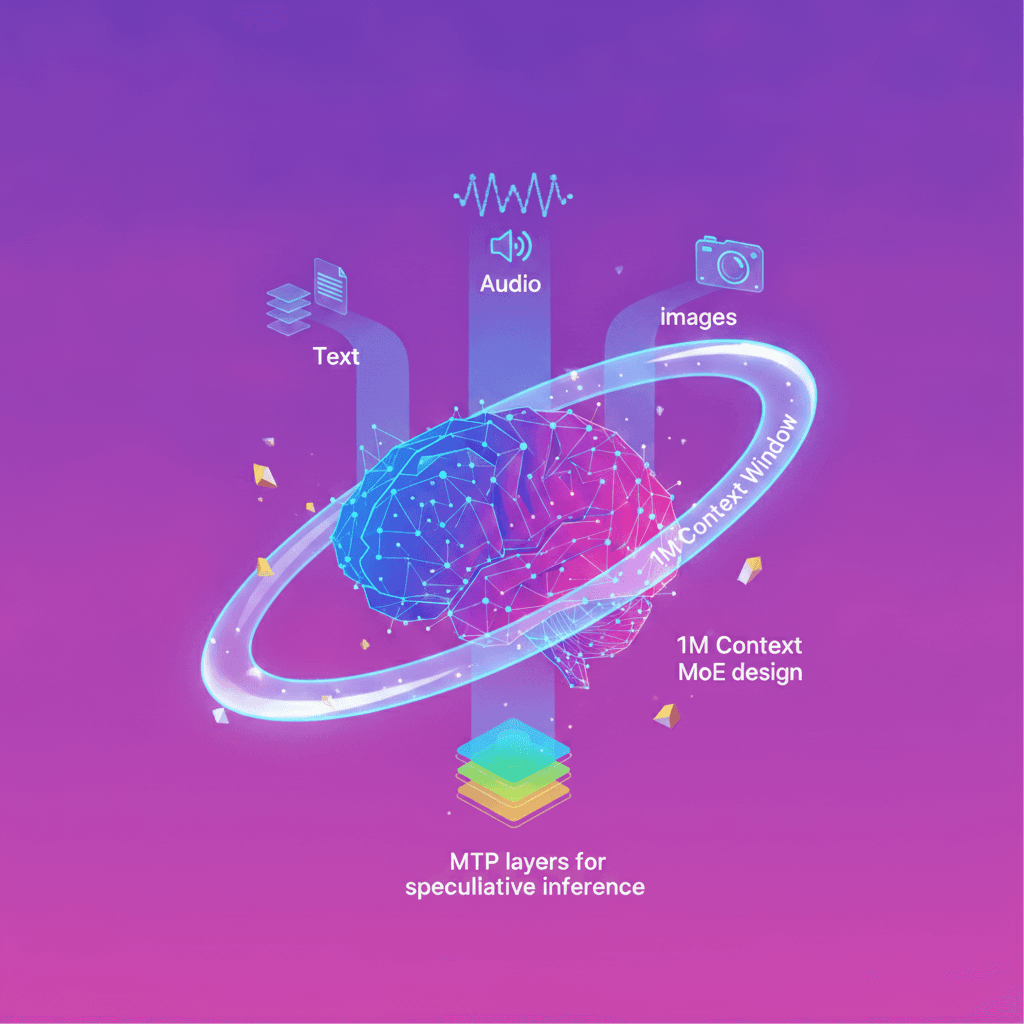
Thinking Machines ha publicado en Hugging Face Inkling, un modelo de IA abierto que puede recibir texto, imágenes y audio en una misma conversación. Su ventana de contexto alcanza 1 millón de tokens, suficiente para trabajar con documentos muy extensos o analizar grandes cantidades de información sin dividirla en tantas partes.
El modelo tiene 975.000 millones de parámetros, aunque solo activa unos 41.000 millones en cada paso gracias a una arquitectura llamada Mixture of Experts. En la práctica, esto permite que un modelo enorme no tenga que utilizar todos sus componentes para responder a cada solicitud.
Thinking Machines afirma que Inkling fue entrenado con 45 billones de tokens procedentes de texto, imágenes, audio y vídeo. Su objetivo principal es razonar combinando modalidades: por ejemplo, leer la etiqueta de un medicamento en una imagen, escuchar una explicación y responder teniendo en cuenta ambas fuentes.
Qué puede hacer Inkling
El modelo funciona como un sistema de entrada y salida flexible. Puede analizar una imagen y responder preguntas sobre ella, transcribir un audio o usar cualquiera de esos contenidos como parte de una tarea de razonamiento.
Algunos ejemplos de uso son:
- Extraer información de documentos escaneados y contestar preguntas sobre ellos.
- Transcribir una grabación y detectar relaciones o errores en lo que se dice.
- Analizar gráficos, fotografías o capturas de pantalla.
- Crear agentes capaces de usar herramientas y trabajar con archivos.
- Adaptarse a tareas concretas mediante ajuste fino, es decir, entrenamiento adicional con datos de un sector o empresa.
La compañía también ha diseñado el modelo para generar respuestas con distintos niveles de esfuerzo de razonamiento. El usuario puede elegir desde una respuesta rápida hasta un análisis más largo. En las pruebas internas compartidas por Thinking Machines, el nivel medio pareció ofrecer un equilibrio entre precisión y consumo de tokens, aunque esas evaluaciones no sustituyen a una comparación independiente.
Un modelo potente, pero no para cualquier ordenador
El principal límite de Inkling es su tamaño. La versión completa en formato BF16 necesita alrededor de 2 TB de memoria de vídeo, mientras que la variante comprimida NVFP4 requiere unos 600 GB y está pensada para GPU Nvidia más recientes.
Eso significa que ejecutarlo localmente no está al alcance de un ordenador convencional. Se puede probar mediante los proveedores de inferencia de Hugging Face, y también existen versiones cuantizadas para llama.cpp que reducen mucho el consumo de memoria. Un equipo de Unsloth asegura haber reducido el tamaño en un 95% con una versión de 1 bit, aunque con una pérdida de precisión frente al modelo original.
Inkling llega con soporte desde el primer día en Transformers, SGLang, vLLM y llama.cpp. También incorpora capas MTP, un sistema que predice varios tokens por adelantado para acelerar la generación sin cambiar la respuesta final cuando la predicción especulativa acierta.
Para ti, la novedad no implica que puedas instalarlo directamente en un portátil. Su importancia está en otro sitio: un modelo abierto combina texto, imagen y audio con una ventana de contexto gigantesca, y además puede ajustarse para tareas específicas. Lo que habrá que vigilar ahora es si esa capacidad se mantiene en evaluaciones independientes y cuánto cuesta utilizarla cuando pase de las demostraciones a aplicaciones reales.