Perplexity lanza Context API para agentes de IA
Perplexity lanza Context API para que los agentes de IA extraigan contenido limpio de hasta 10 páginas web por solicitud. La herramienta ofrece Markdown, HTML, enlaces y fragmentos relevantes, además de controlar si los datos proceden de una copia reciente o de una consulta en directo. La compañía afirma que recuperó contenido utilizable del 92,3 % de 1.000 URLs evaluadas y fija un precio de 1 dólar por cada 1.000 URLs procesadas.
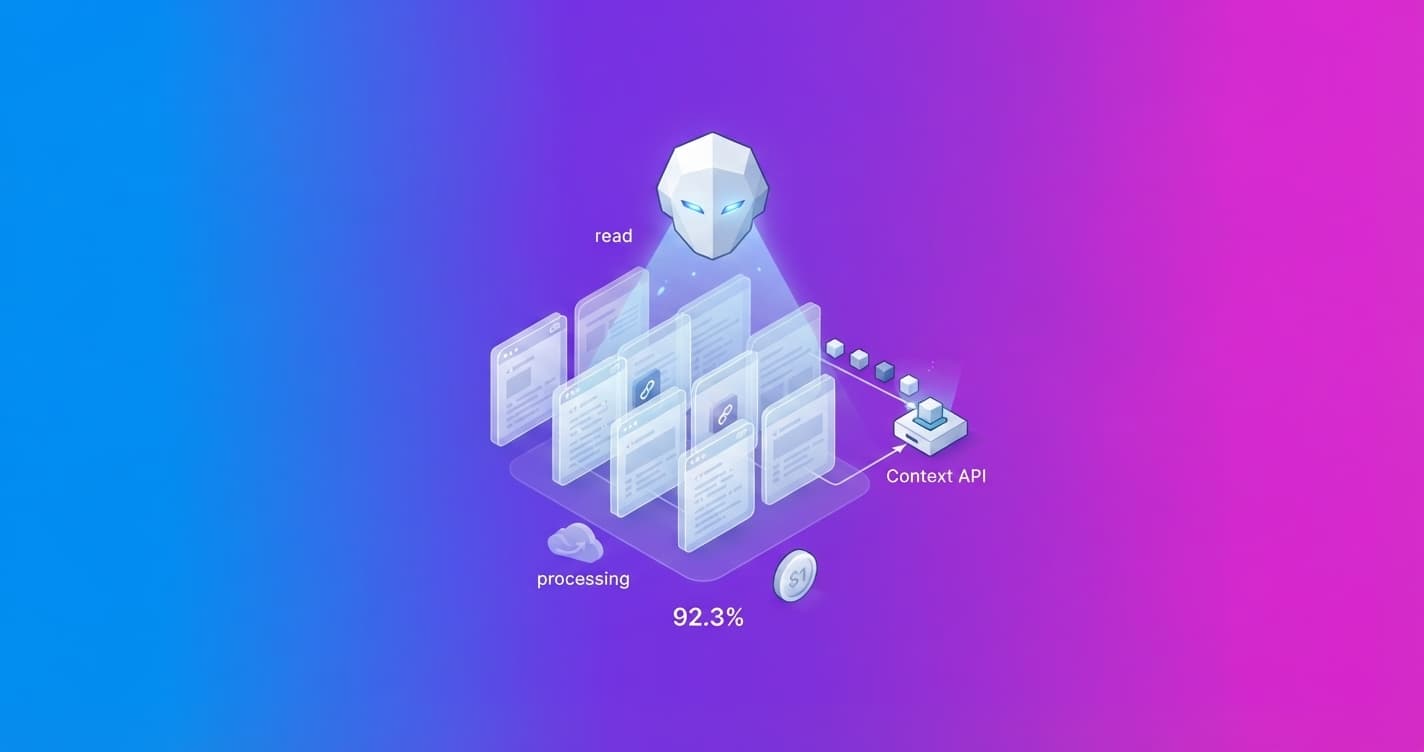
Perplexity ha lanzado Context API, una herramienta que permite a los agentes de IA leer páginas web completas sin quedarse con un fragmento de los resultados de búsqueda ni tragarse todo el código HTML de un sitio.
La API recibe hasta 10 URLs por solicitud y devuelve el contenido limpio en un formato que un modelo puede utilizar directamente. También informa de cuándo se obtuvo cada página y de si procede de una copia almacenada o de una consulta en directo.
De los fragmentos al contenido completo
Cuando un chatbot busca información en internet, normalmente recibe pequeños extractos. Pueden señalar la página correcta, pero suelen dejar fuera detalles importantes: condiciones de uso, excepciones, parámetros técnicos o información sobre precios.
Acceder directamente a la página tampoco resuelve siempre el problema. El HTML suele incluir menús, anuncios, avisos de cookies y otros elementos que ocupan espacio y distraen al modelo.
Context API intenta quedarse con el contenido relevante. Para crear su versión en Markdown, divide cada página en bloques y utiliza un modelo para distinguir el contenido principal del material accesorio. Después conserva los bloques considerados útiles.
Los desarrolladores pueden pedir cuatro tipos de resultado:
- Markdown, con el contenido limpio y preparado para incluirlo en el contexto de un modelo.
- HTML, para que la aplicación haga su propio procesamiento.
- Enlaces, como URLs absolutas sin duplicados y en el orden en que aparecen en la página.
- Fragmentos relevantes, seleccionados según una consulta y limitados al número de tokens que defina el desarrollador.
En este último caso, la API no genera un resumen. Selecciona pasajes originales de la página relacionados con la consulta. Eso permite reducir el texto que el modelo debe procesar sin sustituir las palabras de la fuente por una explicación generada.
Más control sobre la actualidad de los datos
La herramienta también permite decidir cuánto importa que la información sea reciente. Por defecto, Context API busca una copia de la página obtenida durante los últimos dos días en el índice web de Perplexity. Si no la encuentra, realiza una consulta en directo.
Los desarrolladores pueden cambiar ese comportamiento según la tarea:
- Usar
max_age_seconds: 0para consultar siempre la página actual, algo útil con precios, resultados deportivos o noticias de última hora. - Aumentar ese periodo para documentación y otros contenidos que cambian poco.
- Activar
cache_only: truepara impedir cualquier solicitud en directo.
Cada URL se procesa de forma independiente y en paralelo. Si una página tarda demasiado o falla, las demás pueden completarse. El estado de cada resultado permite reintentar solo las URLs problemáticas.
Para qué sirve en la práctica
La diferencia se nota especialmente cuando la respuesta depende de detalles que no aparecen en un buscador:
- Un agente de programación puede recuperar parámetros, instrucciones de autenticación y casos de error de una documentación técnica.
- Un asistente de compras puede comprobar precios actuales junto con límites de uso, condiciones de facturación y requisitos de elegibilidad.
- Un agente de soporte puede leer una política de devoluciones completa y detectar excepciones por producto o región.
- Una herramienta de investigación puede comparar artículos y estudios teniendo en cuenta su metodología y sus matices, no solo el titular o el fragmento mostrado en el buscador.
Qué resultados declara Perplexity
Perplexity probó Context API con 1.000 URLs de 715 sitios, incluidos organismos públicos, fuentes académicas y páginas en idiomas distintos del inglés. Comparó el resultado con Firecrawl, Exa, Parallel, Keenable y Context.dev mediante un modelo evaluador que no sabía qué proveedor había generado cada salida.
Según esa evaluación, Context API:
- Devolvió contenido utilizable en el 92,3 % de las URLs.
- Recuperó el 87,9 % de los datos clave identificados en las páginas.
- Alcanzó un 80,3 % de precisión en el contenido, es decir, la proporción de texto que pertenecía realmente a la página y no a anuncios, menús o avisos.
Son cifras comunicadas por la propia Perplexity y dependen de la muestra y del método de evaluación. No significan que cualquier página vaya a funcionar siempre bien.
El precio anunciado es de 1 dólar por cada 1.000 URLs procesadas. Solo se cobran las URLs que terminan correctamente; las que fallan no generan coste.
Para ti, esto significa que los agentes de IA pueden pasar de encontrar una página a trabajar con ella de forma más fiable. El siguiente punto a vigilar será cómo se comporta la herramienta con sitios que bloquean accesos automáticos, contenido que cambia constantemente y fuentes cuya estructura dificulta separar la información útil del ruido.