OpenAI lanza GPT-5.6 con tres modelos de IA
OpenAI lanza GPT-5.6 con tres modelos: Sol, Terra y Luna, disponibles en ChatGPT, Codex y la API. La familia añade coordinación de agentes, uso programático de herramientas y mejoras en programación, trabajo profesional y ciberseguridad, con precios desde 1 dólar por millón de tokens de entrada.
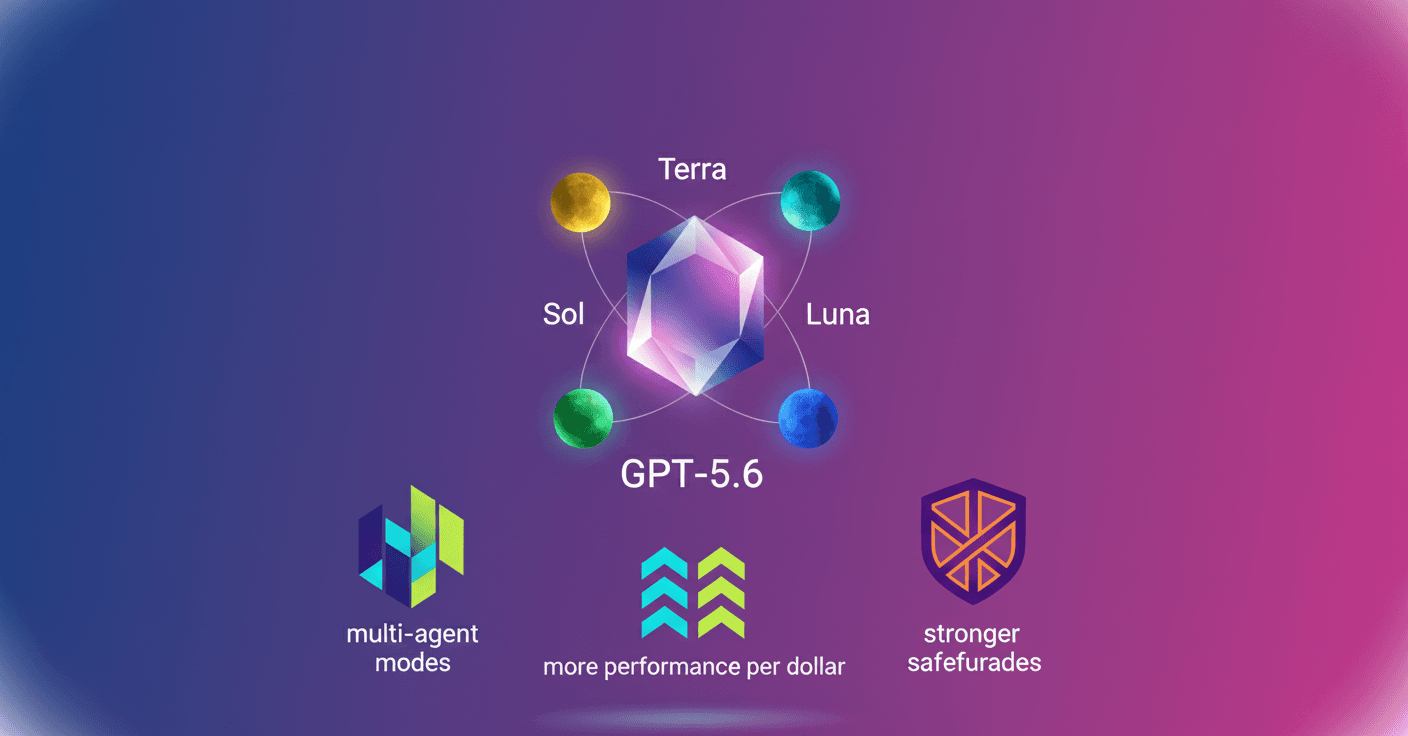
OpenAI ya ofrece GPT-5.6 de forma general en ChatGPT, Codex y su API. La nueva familia llega con tres modelos, Sol, Terra y Luna, además de funciones para coordinar agentes, usar herramientas y completar tareas profesionales con menos tiempo y coste estimado.
El despliegue comenzó el 9 de julio de 2026 y se ampliará gradualmente a todos los usuarios durante las siguientes 24 horas. La disponibilidad depende del plan contratado y del producto que utilices.
Tres modelos para distintos niveles de trabajo
GPT-5.6 no es un único modelo. OpenAI lo divide en tres niveles:
- Sol: el modelo más capaz, pensado para programación, análisis, ciencia, ciberseguridad y tareas complejas.
- Terra: una opción equilibrada para el trabajo diario, con un rendimiento cercano al de GPT-5.5 a menor coste.
- Luna: el modelo más rápido y económico, orientado a tareas frecuentes y de gran volumen.
En la API, los precios por cada millón de tokens son de 5 dólares de entrada y 30 de salida para Sol, 2,50 y 15 dólares para Terra, y 1 y 6 dólares para Luna. Los tokens son las unidades en las que el modelo procesa el texto, por lo que el coste final depende de cuánto contexto recibe y cuánto genera.
OpenAI también incorpora una caché más predecible. Las entradas almacenadas para reutilizarse se cobran a 1,25 veces la tarifa normal, mientras que las lecturas de esa caché mantienen un descuento del 90%.
Más capacidad para tareas largas
La principal novedad no es solo que el modelo responda mejor, sino que puede organizar el trabajo de otra manera. El modo ultra coordina cuatro agentes en paralelo por defecto. Cada uno trabaja en una parte del problema y el sistema reúne después los resultados.
Por ejemplo, una empresa podría pedirle que revise un informe financiero, compruebe sus cifras, compare los datos con documentos externos y prepare una presentación. En lugar de realizar cada paso uno tras otro, los agentes pueden repartirse parte del trabajo.
El modo usa más tokens, así que no está pensado para preguntas sencillas. Su objetivo es reducir el tiempo necesario en tareas que requieren investigación, comprobaciones y varias revisiones. En ChatGPT Work está disponible para los planes Pro y Enterprise, y en Codex para los planes Plus y superiores.
La API también incluye Programmatic Tool Calling. Con esta función, GPT-5.6 puede escribir pequeños programas en memoria para coordinar herramientas, filtrar grandes cantidades de datos y decidir qué hacer a continuación. Eso evita enviar cada resultado intermedio de vuelta al modelo y puede reducir costes, rondas de interacción y supervisión manual.
Qué dicen las pruebas
OpenAI afirma que GPT-5.6 Sol supera a GPT-5.5 y a varios modelos rivales en distintas evaluaciones, aunque los resultados dependen del modo de razonamiento, el uso de herramientas y la configuración de cada prueba.
En programación, Sol alcanza 80 puntos en el Artificial Analysis Coding Agent Index, frente a 76,4 de GPT-5.5. También obtiene un 88,8% en Terminal-Bench 2.1, una prueba de tareas complejas en la línea de comandos. En el modo ultra, sube al 91,9% en esa misma evaluación.
En el uso de ordenadores, Sol logra un 62,6% en OSWorld 2.0, frente al 47,5% de GPT-5.5. En BrowseComp, una prueba de investigación web, llega al 90,4% en su configuración normal y al 92,2% con ultra.
La familia también mejora en ciberseguridad. Sol obtiene un 71,2% en SEC-Bench Pro, frente al 45,8% de GPT-5.5, y un 73,5% en ExploitBench, frente al 47,9%. Estas pruebas miden capacidades técnicas concretas y no significan que el modelo pueda ejecutar ataques autónomos de forma fiable contra objetivos protegidos.
OpenAI asegura además que Sol crea mejores presentaciones, documentos y hojas de cálculo. Puede analizar una plantilla existente, identificar sus tipografías, colores, distribución y reglas de diseño, y aplicar esa estructura a nuevo contenido. En la práctica, esto busca reducir el trabajo de corregir diapositivas o informes generados automáticamente.
Más controles para usos de riesgo
GPT-5.6 llega con una supervisión más estricta en ciberseguridad y biología. OpenAI combinó pruebas automatizadas, equipos externos de evaluación y cerca de 700.000 horas de GPU A100e de pruebas automatizadas para buscar fallos y formas de saltarse las restricciones.
La empresa dice que el modelo es más útil para encontrar y corregir vulnerabilidades que para realizar ataques completos contra sistemas reforzados. Las capacidades defensivas más avanzadas quedan reservadas a usuarios verificados mediante el programa Trusted Access for Cyber.
Este enfoque puede generar más bloqueos en tareas legítimas. OpenAI afirma que las salvaguardas de Sol bloquean aproximadamente diez veces más actividad potencialmente dañina que las de modelos anteriores, aunque reconoce que seguirá ajustándolas para reducir falsos positivos.
Qué cambia para ti
Los usuarios de Plus, Pro, Business y Enterprise pueden acceder a GPT-5.6 Sol en ChatGPT con niveles de esfuerzo medio o superiores. Pro y Enterprise también pueden seleccionar Sol Pro para trabajos complejos. Los usuarios Free y Go reciben Terra en ChatGPT Work y Codex, mientras que los planes superiores pueden elegir entre Sol, Terra y Luna según el producto.
Para un uso cotidiano, la diferencia más visible estará en la calidad de documentos, presentaciones, análisis y tareas que exigen utilizar varias herramientas. Para los desarrolladores, el cambio importante es que el modelo puede coordinar mejor esos pasos por sí mismo y hacerlo con menos llamadas a la API.
GPT-5.6 también muestra que la competencia ya no se centra únicamente en quién obtiene la puntuación más alta. El coste, el tiempo de respuesta, la capacidad de trabajar con programas y la posibilidad de repartir una tarea entre varios agentes son igual de importantes. Lo que habrá que vigilar ahora es cuánto de estas mejoras se mantiene en trabajos reales, donde los datos, las instrucciones y los errores de las herramientas pueden cambiar mucho el resultado.