OpenAI blinda sus modelos de IA contra la destilación
OpenAI refuerza sus modelos para frenar la destilación adversarial, una práctica que puede transferir capacidades avanzadas a sistemas con menos controles. Sus pruebas internas reducen la tasa media de extracción del razonamiento protegido del 54,0 % al 0,2 % en GPT-6.2 Astra.
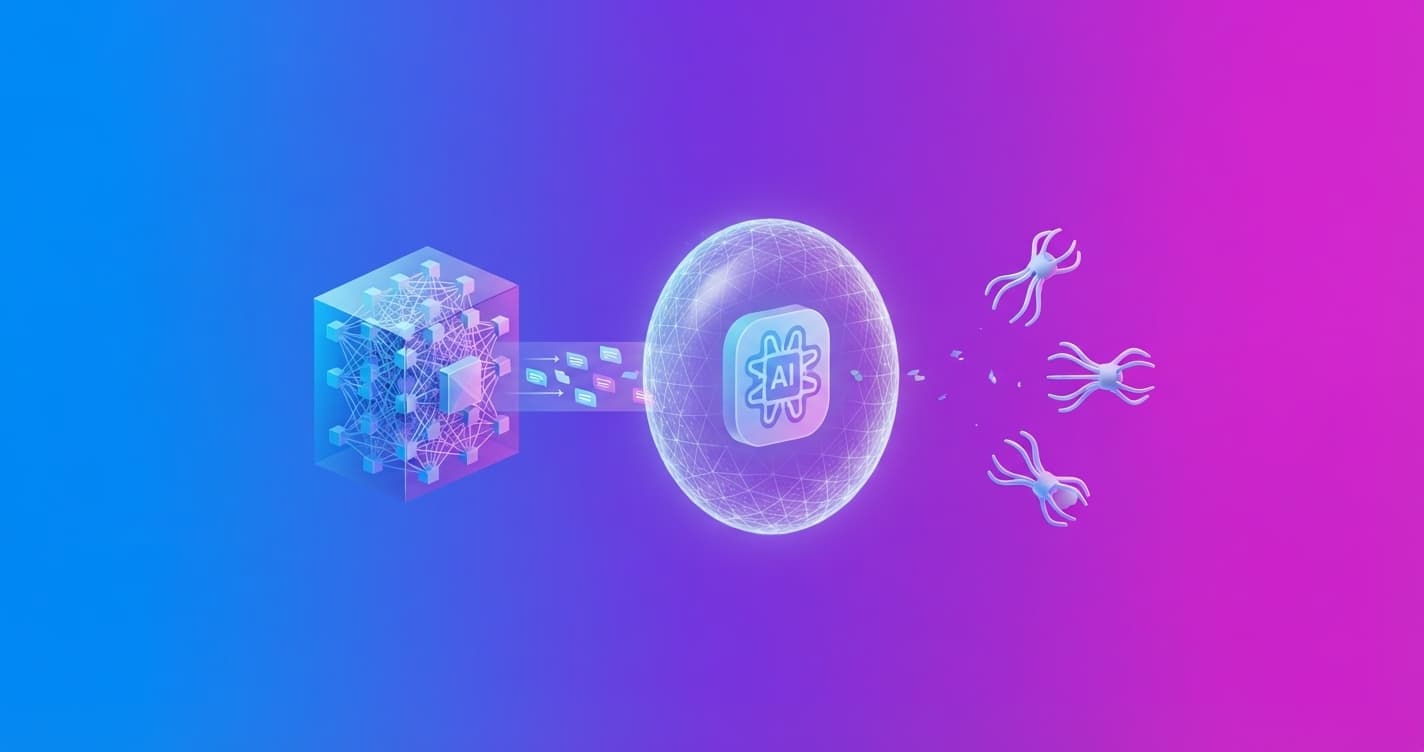
OpenAI está reforzando sus modelos de IA para impedir que otras empresas o actores extraigan sus capacidades y las reproduzcan sin las mismas medidas de seguridad. La compañía llama a esta práctica destilación adversarial y asegura que ya ha detectado varias campañas de este tipo.
La destilación es una técnica legítima de aprendizaje automático: un modelo, llamado profesor, genera respuestas que sirven para entrenar a otro, llamado estudiante. El problema aparece cuando alguien recopila esas respuestas sin autorización para crear un modelo con capacidades avanzadas, pero sin los filtros que impedían al modelo original ayudar en tareas peligrosas.
Por ejemplo, un modelo puede ayudar a un investigador a encontrar vulnerabilidades en un sistema. Si se recopilan suficientes respuestas y se usan para entrenar otro modelo, ese estudiante podría aprender a aplicar conocimientos similares con fines ofensivos, aunque el modelo original se hubiera negado a dar esas instrucciones.
El objetivo: proteger el razonamiento interno
OpenAI centra buena parte de sus defensas en el llamado chain-of-thought, las trazas de razonamiento que un modelo genera mientras prepara una respuesta. Esas trazas pueden contener pasos intermedios que no aparecen en la respuesta final y, por eso, resultar especialmente útiles para entrenar otro sistema.
La compañía probó sus defensas con equipos automatizados que intentaban recuperar ese razonamiento protegido a partir de conversaciones anteriores. En una evaluación interna, la tasa media de éxito de los ataques pasó del 54,0 % en GPT-6 Astra con sus protecciones originales al 0,2 % en GPT-6.2 Astra con las nuevas medidas.
En otra prueba adaptativa de tipo caja negra, en la que los atacantes solo veían lo que vería un usuario externo, la tasa de éxito quedó por debajo del 1 % para cada tipo de ataque en GPT-6.2 Astra. OpenAI señala que estos resultados proceden de evaluaciones internas y que sigue aplicando algunas mejoras a GPT-6 Astra.
Más que bloquear una petición
La estrategia combina varias capas. Los modelos reciben entrenamiento para rechazar intentos de extraer su razonamiento, mientras que clasificadores revisan tanto las solicitudes como las respuestas generadas.
La revisión también cubre los argumentos enviados a herramientas externas. Un modelo podría filtrar información protegida no en su respuesta visible, sino dentro de una llamada a una herramienta. Los clasificadores de salida pueden bloquear ese contenido antes de que llegue al usuario o a otro sistema.
Además, las protecciones de la API limitan cómo puede reutilizarse el razonamiento entre conversaciones, usuarios, organizaciones y familias de modelos. En GPT-6.2 Astra y GPT-6.2 Sol, ese razonamiento queda vinculado al historial de la conversación que lo produjo. Si se reescribe un mensaje anterior, la API elimina el razonamiento generado después de ese punto.
OpenAI también busca campañas coordinadas, no solo peticiones individuales. Cuando identifica una red que intenta extraer capacidades de forma sistemática, investiga las cuentas relacionadas y puede aplicar medidas a miles o decenas de miles de cuentas cada semana, según la empresa. También comparte indicadores de compromiso con otros proveedores para que puedan buscar actividad similar.
Qué cambia para ti
Si usas estos modelos para programar, investigar o trabajar con herramientas, la experiencia debería cambiar poco. Las solicitudes legítimas de explicaciones y asistencia seguirán permitidas, pero los intentos de obtener el razonamiento privado o de reutilizarlo entre modelos encontrarán más barreras.
El impacto más importante está en los modelos que podrían copiar capacidades en áreas de doble uso, como:
- Ciberseguridad, donde una técnica defensiva también puede servir para atacar sistemas.
- Biología, donde conocimientos útiles para investigar pueden facilitar el desarrollo de amenazas.
- Automatización avanzada, si un modelo sin controles recibe suficiente material de otro más protegido.
OpenAI afirma que ha identificado campañas vinculadas a la destilación de modelos de frontera y que este problema también tiene una dimensión de seguridad nacional. La empresa ha informado al Congreso estadounidense sobre supuestos intentos asociados con DeepSeek y Moonshot AI, aunque esos señalamientos forman parte de sus propias investigaciones.
La lección que OpenAI quiere extender al resto de la industria es concreta: proteger el razonamiento no basta. Los proveedores necesitan combinar filtros en cada solicitud con vigilancia de campañas completas, pruebas automáticas que intenten romper las defensas y coordinación entre empresas.
A medida que los modelos avanzados se vuelven más accesibles, la disputa no será solo por quién entrena el sistema más capaz. También será por quién consigue evitar que esas capacidades se copien sin los límites que las hacen utilizables de forma segura.