Google presenta T5Gemma 2, su IA multimodal
Google presenta T5Gemma 2, una familia de modelos encoder-decoder que entiende texto e imágenes, trabaja con hasta 128.000 tokens y admite más de 140 idiomas. Sus versiones compactas están pensadas para que los desarrolladores las adapten a tareas concretas y las ejecuten con menos recursos.
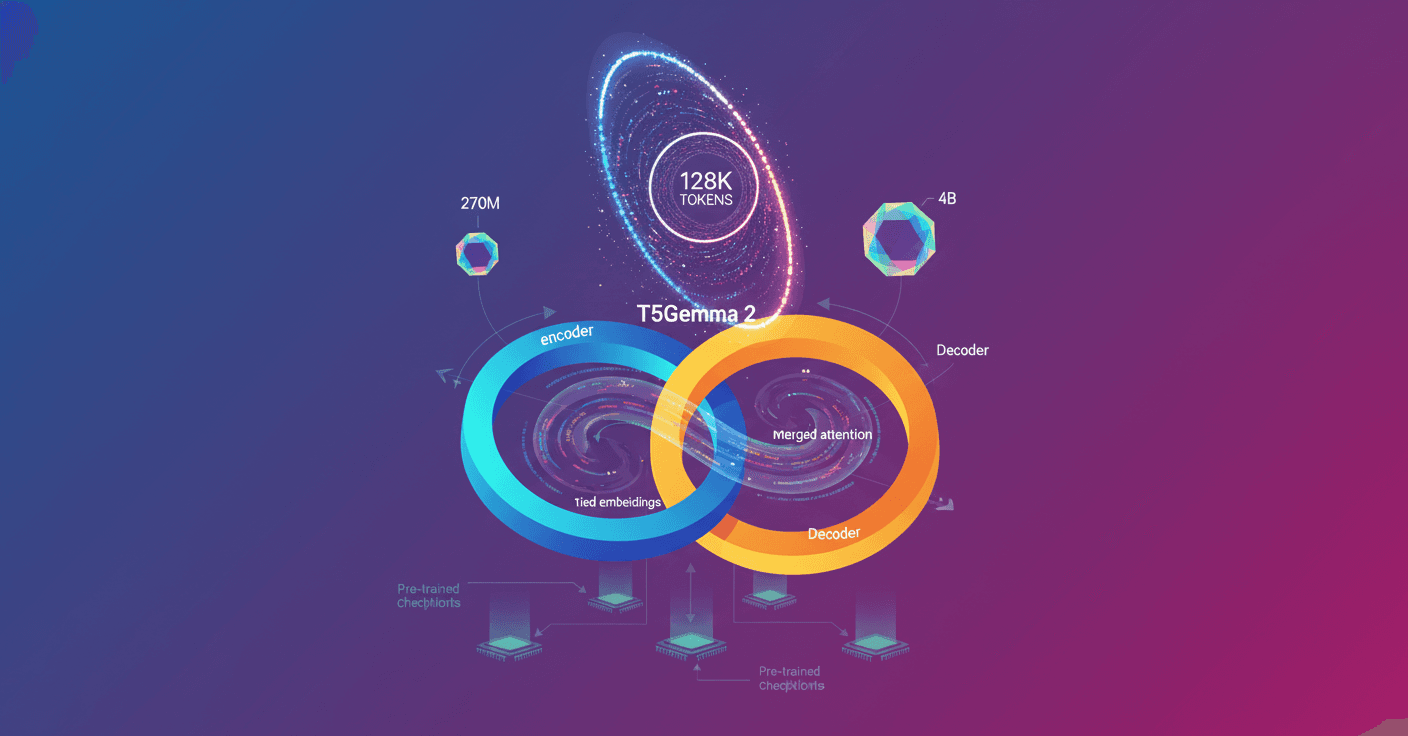
Google ha presentado T5Gemma 2, una nueva familia de modelos de inteligencia artificial que combina texto e imágenes, puede trabajar con hasta 128.000 tokens de contexto y admite más de 140 idiomas. Está basada en Gemma 3 y llega en tamaños compactos para investigación, desarrollo y uso en dispositivos.
A diferencia de los modelos que solo generan texto de principio a fin, T5Gemma 2 utiliza una arquitectura de tipo encoder-decoder. El codificador analiza la información de entrada y el decodificador produce la respuesta. Esta separación resulta útil para tareas como resumir documentos, traducir, responder preguntas sobre una imagen o procesar textos extensos.
Modelos más pequeños y eficientes
La familia incluye tres configuraciones principales:
270M-270M, con unos 370 millones de parámetros en total, sin contar el codificador visual.1B-1B, con alrededor de 1.700 millones de parámetros.4B-4B, con cerca de 7.000 millones de parámetros.
Los dos números indican el tamaño aproximado del codificador y el decodificador. La versión más pequeña está pensada para experimentar con rapidez y facilitar despliegues en dispositivos con recursos limitados.
Google ha reducido el tamaño y la complejidad de la arquitectura con dos cambios. Primero, el codificador y el decodificador comparten las mismas representaciones de palabras, una técnica que evita guardar información duplicada. Segundo, el decodificador combina la atención sobre el texto generado y la atención sobre la entrada en una sola capa.
El resultado, según Google, es un modelo con menos parámetros y más sencillo de distribuir en paralelo. En la práctica, esto puede ayudar a ejecutar tareas de IA con menos memoria y a probar distintas aplicaciones sin depender siempre de grandes servidores.
Imágenes, documentos largos y muchos idiomas
T5Gemma 2 incorpora un codificador visual eficiente, por lo que puede analizar imágenes junto con instrucciones escritas. Por ejemplo, puede responder preguntas sobre una fotografía, extraer información de un documento escaneado o relacionar una imagen con un texto.
También amplía de forma notable la cantidad de información que puede recibir en una sola petición. Sus ventanas de contexto llegan hasta 128K tokens, lo que permite trabajar con documentos largos, colecciones de archivos o historiales extensos sin dividirlos en tantos fragmentos.
El modelo ha sido entrenado para admitir más de 140 idiomas. Esto amplía su utilidad para traducción, clasificación de textos y asistentes que deben funcionar fuera del inglés.
Qué muestran las pruebas
Google afirma que T5Gemma 2 supera a modelos Gemma 3 equivalentes en varias pruebas de capacidades multimodales, contexto largo, programación, razonamiento y tareas multilingües. La compañía también señala que el uso de un codificador separado mejora especialmente el procesamiento de textos extensos.
Estas comparaciones deben leerse con una precisión importante: los resultados publicados corresponden principalmente a modelos preentrenados. Google no está lanzando en esta versión puntos de control ya ajustados para conversación o instrucciones.
La empresa sí realizó un ajuste supervisado mínimo, sin aprendizaje por refuerzo, para ilustrar el rendimiento posterior al entrenamiento. Esos resultados no son directamente comparables con los gráficos de preentrenamiento porque utilizan pruebas distintas.
Qué cambia para ti
T5Gemma 2 no es un asistente listo para usar, sino una base que los desarrolladores pueden adaptar a tareas concretas antes de ponerla en producción. Eso puede incluir un sistema que responda sobre manuales internos, analice imágenes médicas o procese contratos en varios idiomas, siempre que se entrene y evalúe para ese propósito.
Los puntos de control preentrenados ya están disponibles para que la comunidad los pruebe y los ajuste. Lo relevante será comprobar si su menor tamaño mantiene esas capacidades cuando se ejecutan en dispositivos reales, con datos propios y bajo las limitaciones habituales de memoria y velocidad.