Gemini 3 Flash activa una visión que investiga imágenes
Gemini 3 Flash incorpora Agentic Vision, una capacidad que le permite ampliar, recortar, anotar y analizar imágenes mediante código antes de responder. Google asegura una mejora media del 5% al 10% en la mayoría de las pruebas de visión, y ya está disponible en sus herramientas para desarrolladores.
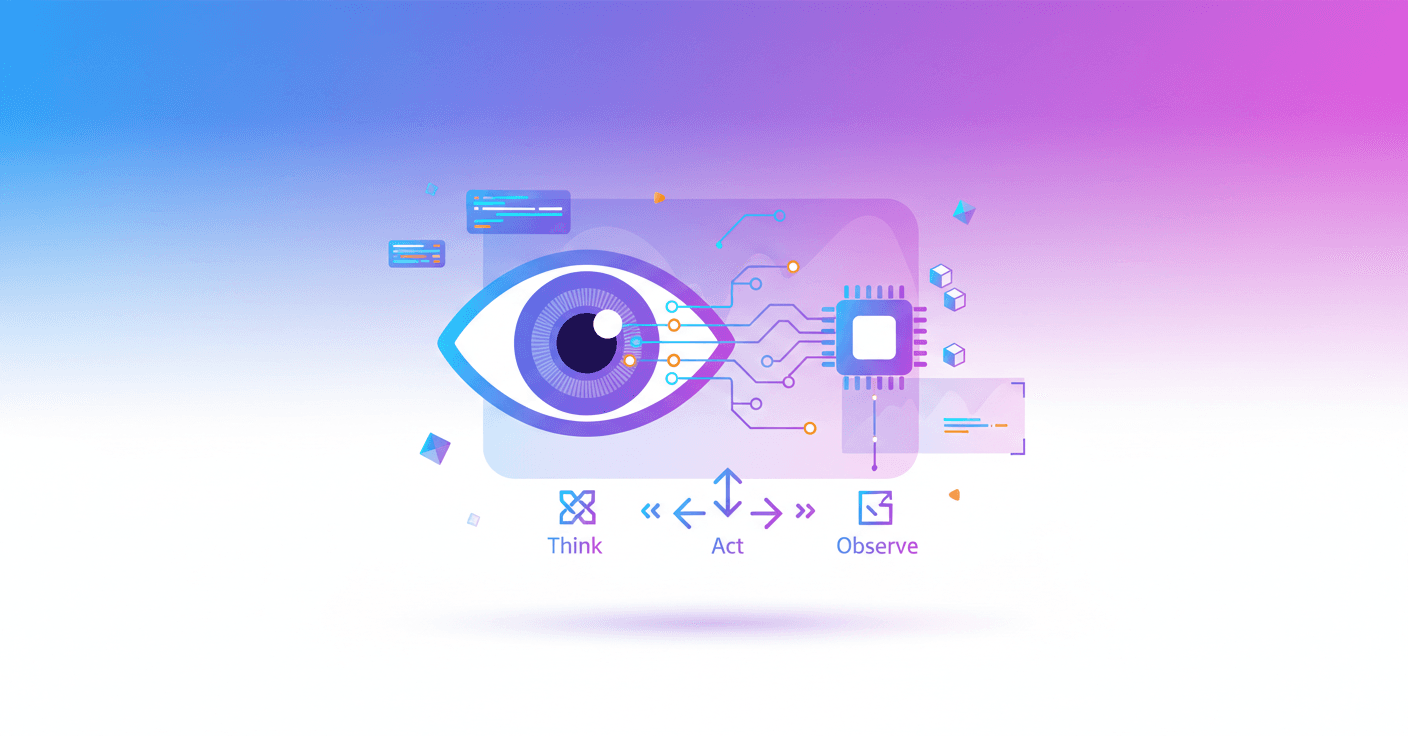
Gemini 3 Flash ya no tiene que conformarse con mirar una imagen una sola vez: ahora puede hacer zoom, recortar zonas, rotarlas, marcar objetos y ejecutar cálculos para comprobar lo que está viendo.
Google llama a esta capacidad Agentic Vision. Está disponible mediante la API de Gemini en Google AI Studio y Vertex AI, y empieza a llegar a la aplicación de Gemini con el modo Thinking.
De mirar una imagen a investigarla
Los modelos de IA suelen analizar una imagen de forma estática. Si un número de serie aparece demasiado pequeño o una señal está lejos, el modelo puede pasarla por alto y terminar adivinando.
Agentic Vision convierte ese proceso en una investigación por pasos. Gemini 3 Flash analiza primero la pregunta y la imagen, decide qué necesita revisar y utiliza ejecución de código para modificarla o calcular datos antes de responder.
El funcionamiento sigue un ciclo sencillo:
- Pensar: el modelo interpreta la petición y prepara un plan.
- Actuar: genera y ejecuta código en Python para recortar, girar, anotar o analizar la imagen.
- Observar: incorpora la nueva versión de la imagen a su contexto y vuelve a examinarla con más información.
El modelo no solo describe lo que ve. Puede crear una especie de borrador visual para comprobar su propio razonamiento.
Qué puede hacer en la práctica
Una de las aplicaciones más claras es inspeccionar detalles pequeños. Gemini 3 Flash puede detectar que necesita ampliar una parte concreta de una imagen, recortarla y volver a analizarla.
PlanCheckSolver.com, una plataforma que valida planos de construcción, afirma que mejoró su precisión un 5% al activar la ejecución de código. El modelo revisa zonas específicas, como bordes del tejado o secciones del plano, y utiliza esos recortes para comprobar el cumplimiento de normas de construcción.
También puede anotar directamente la imagen. En una demostración, Gemini recibe una fotografía de una mano y debe contar los dedos. Para reducir errores, genera código que dibuja recuadros y etiquetas numéricas sobre cada dedo identificado.
Ese método no garantiza que la IA nunca se equivoque, pero hace que la respuesta se apoye en elementos visibles y comprobables, en lugar de depender solo de una impresión general.
Menos cálculos a ojo
La capacidad también sirve para trabajar con tablas, gráficos y datos visuales. Gemini puede extraer los valores de una tabla, ejecutar operaciones en Python y crear una visualización con herramientas como Matplotlib.
Esto es importante porque los modelos de lenguaje pueden cometer errores al realizar operaciones con varios pasos. En este caso, el cálculo se delega a un entorno determinista, que sigue instrucciones matemáticas concretas en lugar de intentar resolverlas mediante predicción de texto.
Google asegura que activar la ejecución de código proporciona una mejora de entre el 5% y el 10% en promedio en la mayoría de las pruebas de visión. La cifra corresponde a benchmarks, no a una mejora garantizada en cada imagen o aplicación.
Qué cambia para ti
Si usas Gemini para analizar documentos, planos, capturas de pantalla o fotografías con detalles pequeños, la IA puede dedicar más pasos a revisar la información antes de contestar. Para un desarrollador, esto abre aplicaciones como:
- Verificar automáticamente elementos concretos de un plano.
- Contar y localizar objetos en una imagen.
- Leer tablas densas y convertirlas en gráficos.
- Comprobar visualmente una respuesta mediante recortes y anotaciones.
Por ahora, no todos estos comportamientos se activan solos. Gemini 3 Flash decide implícitamente cuándo hacer zoom, pero algunas acciones, como girar una imagen o realizar cálculos visuales, todavía pueden necesitar una instrucción explícita.
Agentic Vision está disponible en la API de Gemini, Google AI Studio y Vertex AI. En AI Studio se puede probar activando Code Execution dentro de las herramientas. Google también trabaja en añadir búsqueda web y búsqueda inversa de imágenes, además de llevar la capacidad a otros tamaños de modelo.
La dirección es clara: la visión de la IA deja de ser una fotografía instantánea y se parece más a una inspección guiada. El siguiente punto que conviene vigilar es cuánto de ese proceso puede hacer el modelo por sí solo y cuándo seguirá necesitando que tú le indiques exactamente qué debe revisar.