Falcon Perception lleva la IA a escenas complejas
Falcon Perception es un modelo abierto de 0,6 mil millones de parámetros que segmenta objetos a partir de instrucciones complejas, como su posición, atributos o relaciones. En SA-Co supera a SAM 3, aunque todavía falla más al decidir cuándo un objeto no está presente. TII también presenta Falcon OCR, un modelo de 0,3 mil millones de parámetros para reconocer documentos, tablas y fórmulas con alto rendimiento y bajo coste de servicio.
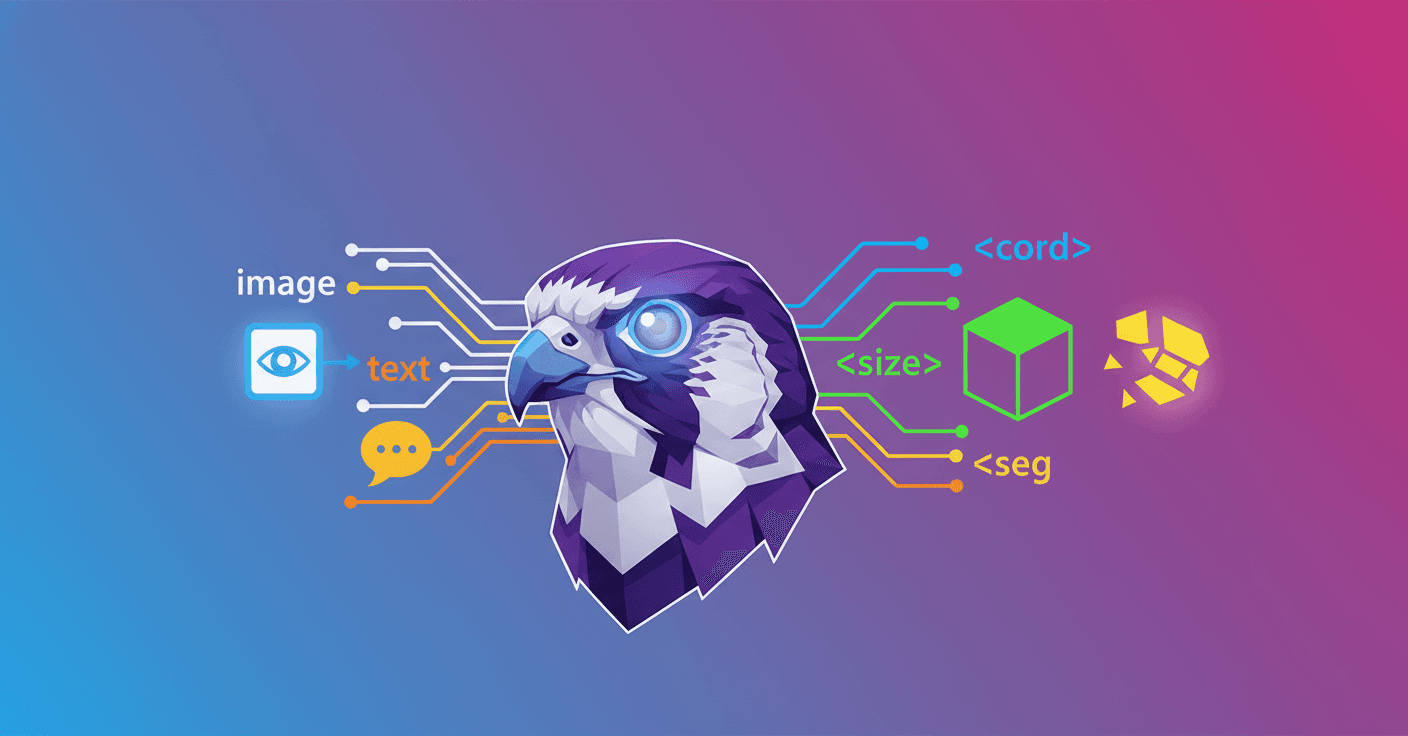
Falcon Perception es un modelo abierto de IA que puede encontrar y recortar objetos en una imagen a partir de instrucciones detalladas, incluso cuando debe leer texto, entender posiciones o distinguir relaciones entre personas y objetos. Su versión principal tiene 0,6 mil millones de parámetros, una escala pequeña frente a muchos modelos de visión actuales.
El modelo fue presentado por el Falcon Vision Team del Technology Innovation Institute (TII), en Abu Dabi. Su propuesta combina en una sola arquitectura la comprensión de imágenes y del lenguaje, en lugar de separar el proceso en un encoder visual, un módulo de fusión y varios componentes especializados.
Una sola secuencia para imagen y texto
Falcon Perception convierte los parches de una imagen, las palabras de la instrucción y las órdenes de la tarea en una secuencia común. Pero no trata todos los elementos de la misma manera:
- Los tokens de imagen pueden atender a toda la imagen para construir un contexto visual completo.
- Los tokens de texto se procesan de forma causal, usando la imagen y las palabras anteriores como contexto.
- Las instrucciones de salida siguen una estructura fija: coordenadas, tamaño y máscara.
Esta combinación permite que el modelo comprenda la escena como un sistema visual y, al mismo tiempo, responda paso a paso a una petición escrita.
Para cada objeto, Falcon Perception primero localiza su centro, después calcula su tamaño y finalmente genera una representación que se transforma en una máscara de píxeles. Ese orden ayuda a resolver una dificultad habitual: saber exactamente a cuál de los muchos objetos parecidos se refiere la instrucción.
Por ejemplo, no se limita a localizar cualquier botella. Puede intentar encontrar la botella de vino con la etiqueta 168, el coche negro situado a la derecha del coche rojo o la persona que sostiene un casco.
Mejores resultados cuando la instrucción es difícil
En el benchmark de segmentación abierta SA-Co, Falcon Perception obtiene 68,0 de Macro-F1, frente a 62,3 de SAM 3. Macro-F1 es una métrica que resume el rendimiento medio en varias categorías, dando el mismo peso a cada una.
La ventaja crece cuando la tarea exige combinar varias pistas. En el nuevo benchmark PBench, diseñado para separar capacidades concretas, el modelo supera a SAM 3 en:
- Atributos: 63,6 frente a 54,4.
- Identificación guiada por texto leído en la imagen: 38,0 frente a 24,6.
- Relaciones espaciales: 53,5 frente a 31,6.
- Relaciones entre objetos o personas: 49,1 frente a 33,3.
- Escenas densas: 72,6 frente a 58,4.
PBench también prueba imágenes con cientos de objetos. Según TII, Falcon Perception puede segmentar esas instancias una tras otra, mientras que el decodificador de SAM 3 puede quedarse sin consultas disponibles cuando hay más de unas 200.
El resultado no es perfecto. Su principal debilidad está en la calibración de presencia, es decir, en decidir correctamente cuándo el objeto pedido no aparece en la imagen. En esa medida, Falcon Perception logra un MCC de 0,64, frente a 0,82 de SAM 3. Puede localizar bien un objeto cuando está presente, pero todavía debe mejorar al responder que no existe.
También llega Falcon OCR
El anuncio incluye Falcon OCR, un modelo separado de 0,3 mil millones de parámetros para convertir imágenes de documentos en texto estructurado. Procesa páginas con varias columnas, tablas, fórmulas matemáticas, escritura a mano y fotografías tomadas en condiciones reales.
En las pruebas publicadas obtiene:
- 80,3 % en olmOCR, a solo 1,7 puntos del sistema líder de esa evaluación.
- 88,64 puntos en OmniDocBench, por delante de
DeepSeek OCR v2,GPT 5.2yMistral OCR 3en la comparación presentada. - 87,1 % en documentos de varias columnas y 90,3 % en tablas dentro de olmOCR.
Su tamaño también busca reducir el coste de servir el modelo. En una A100 de 80 GB, con alta concurrencia y vLLM, alcanza 2,9 imágenes por segundo para el flujo completo de detección de diseño y reconocimiento de texto. TII indica que es aproximadamente tres veces más pequeño que los modelos OCR de la clase de 0,9 mil millones de parámetros.
Qué cambia para ti
La utilidad práctica está en poder dar instrucciones más precisas a una imagen, no solo pedir una lista de objetos. Una aplicación podría localizar productos concretos en un estante, revisar documentos escaneados, separar cientos de elementos en una fotografía o encontrar una persona por la acción que realiza.
El enfoque también puede reducir la complejidad de despliegue: un backbone compartido, salidas ligeras y atención optimizada para procesar secuencias de longitud variable. TII ofrece una pila de inferencia basada en PyTorch FlexAttention, integración con vLLM y soporte de MLX para equipos con chips de Apple.
Falcon Perception todavía debe mejorar su capacidad para descartar objetos ausentes y sus resultados dependen de la resolución, la longitud de la secuencia y la cantidad de instancias. Pero el anuncio apunta a una dirección concreta: modelos más pequeños que entienden simultáneamente lenguaje, texto dentro de imágenes, geometría y relaciones, sin depender de una cadena cada vez más larga de módulos especializados.