DiScoFormer estima densidad y score con un transformer
Ai2 presenta DiScoFormer, un transformer que estima densidad y score a partir de una muestra sin reentrenarse para cada distribución. En 100 dimensiones, reduce frente a KDE el error del score unas 6,5 veces y el de densidad más de 37 veces.
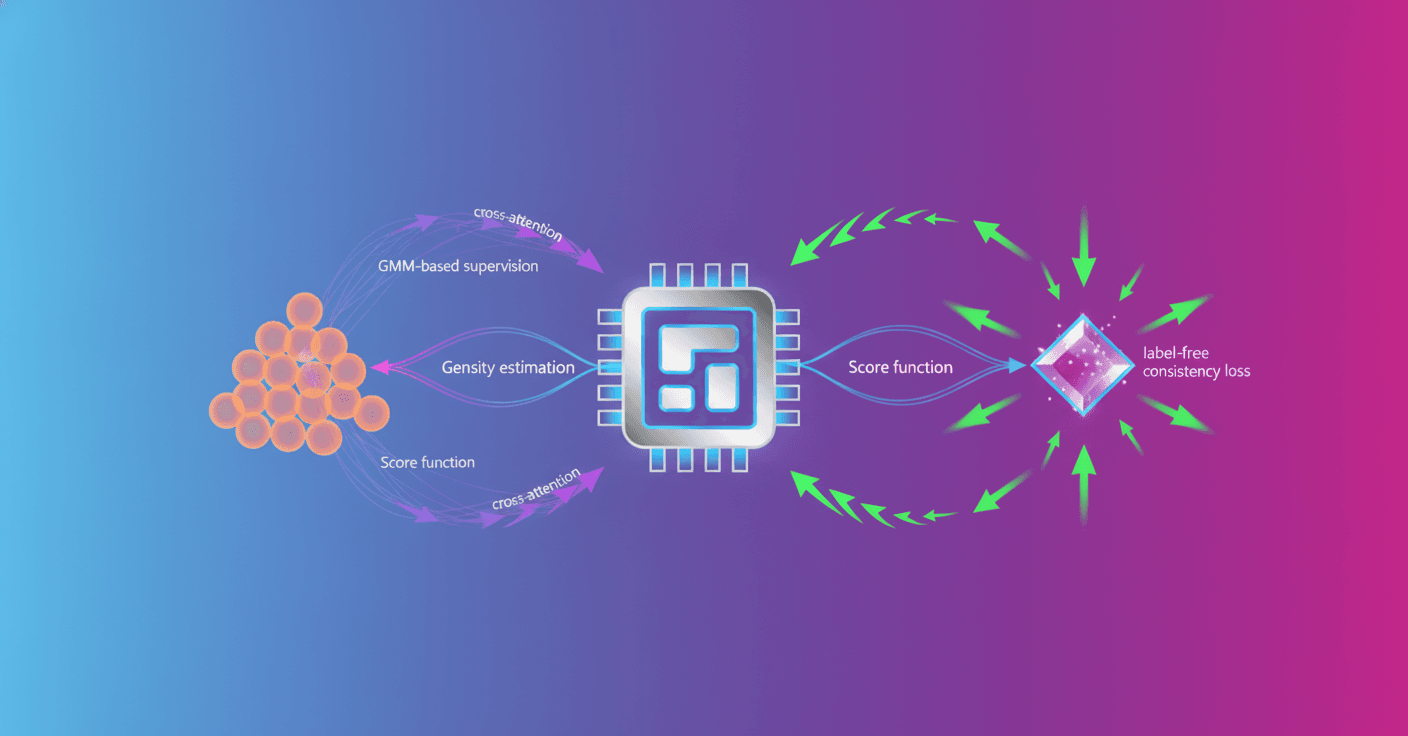
DiScoFormer es un nuevo modelo de IA que estima, en una sola pasada, dos propiedades clave de una distribución de datos: su densidad y su score. La propuesta de Ai2 busca reemplazar el equilibrio actual entre métodos fáciles de reutilizar pero poco precisos y modelos precisos que deben entrenarse de nuevo para cada problema.
Qué calcula DiScoFormer
Imagina un conjunto de puntos y una pregunta: ¿en qué zonas se concentran los datos y cuáles son poco frecuentes? La densidad responde a la primera parte. Es una versión continua de un histograma: sube donde hay muchos puntos y baja donde hay pocos.
El score es el gradiente del logaritmo de esa densidad. Dicho de forma práctica, indica hacia dónde moverse para llegar a una zona más probable. Esa dirección es fundamental en los modelos de difusión que generan imágenes, pero también en el muestreo bayesiano y en simulaciones científicas, como las que estudian el plasma.
DiScoFormer recibe una muestra de datos y puede calcular la densidad y el score en cualquier punto, aunque ese punto no aparezca en la muestra. Lo hace con un transformer, una arquitectura capaz de relacionar cada consulta con todos los datos disponibles mediante un mecanismo llamado atención cruzada.
La ventaja frente a los métodos actuales
Uno de los métodos clásicos es la estimación de densidad por kernels, conocida como KDE. El sistema calcula la densidad observando qué puntos están cerca de cada posición. No necesita entrenamiento y funciona con muchos tipos de distribuciones, pero pierde precisión rápidamente cuando aumentan las dimensiones.
Los modelos neuronales que aprenden el score suelen comportarse mejor en espacios de alta dimensión. El problema es que cada modelo debe aprender una distribución concreta y volver a entrenarse cuando cambia el problema.
DiScoFormer intenta combinar ambas ventajas:
- Puede reutilizarse en distintas distribuciones sin volver a entrenarse.
- Estima densidad y score con el mismo modelo.
- Mantiene un rendimiento más estable cuando crece el número de dimensiones.
- Incluye a
KDEcomo un caso particular dentro de su arquitectura.
Los investigadores muestran que una cabeza de atención puede comportarse de forma parecida a un kernel gaussiano. La diferencia es que DiScoFormer puede aprender varias escalas de influencia y adaptarlas a los datos, en lugar de usar una única distancia fija para todos los casos.
Cómo aprende y cómo se adapta
Para entrenarlo, Ai2 utiliza modelos de mezcla de gaussianas, conocidos como GMM. Son combinaciones de varias distribuciones gaussianas que pueden aproximar una gran variedad de formas. Además, permiten calcular de manera exacta tanto la densidad como el score, lo que proporciona objetivos precisos para entrenar el modelo.
DiScoFormer comparte una parte de su red entre ambas tareas y utiliza dos salidas: una para la densidad y otra para el score. Como el score debe ser matemáticamente igual al gradiente del logaritmo de la densidad, el modelo puede detectar si sus dos predicciones no encajan entre sí.
Esa relación también sirve para adaptarlo durante la inferencia. Con la muestra fija, el modelo realiza unos pasos de ajuste usando solo esa inconsistencia, sin necesitar las respuestas correctas. Así puede corregirse sobre la marcha cuando recibe datos que se alejan de los ejemplos usados durante el entrenamiento.
Resultados en alta dimensión
Según las pruebas de Ai2, DiScoFormer supera a KDE tanto al estimar la densidad como al calcular el score. En 100 dimensiones, reduce el error del score unas 6,5 veces frente a la mejor versión ajustada de KDE, y el error de densidad en más de 37 veces.
El modelo también mantiene su precisión con distribuciones que tienen más modos de los vistos durante el entrenamiento y con formas no gaussianas, como las distribuciones de Laplace y Student-t. En cambio, KDE conserva una ventaja importante: suele ser más rápido cuando hay pocos datos.
Para ti, la importancia no está en usar DiScoFormer como una aplicación independiente, sino en lo que podría ahorrar detrás de muchas herramientas de IA. Un estimador reutilizable del score podría servir como componente común en generadores por difusión, sistemas de inferencia bayesiana y simulaciones científicas, sin entrenar un modelo nuevo para cada distribución.
El siguiente punto que habrá que vigilar es si ese rendimiento se mantiene fuera de los experimentos controlados con mezclas de gaussianas y en problemas reales de mayor escala. La idea central ya está clara: una misma red puede aprender a leer una distribución, medir dónde se concentra y señalar cómo avanzar hacia sus regiones más probables.