Anthropic explica por qué Claude adopta rasgos humanos
Anthropic propone el modelo de selección de personas para explicar por qué Claude adopta rasgos, emociones y conductas humanas. La teoría sostiene que el entrenamiento no crea una personalidad desde cero, sino que refina personajes aprendidos durante la formación inicial.
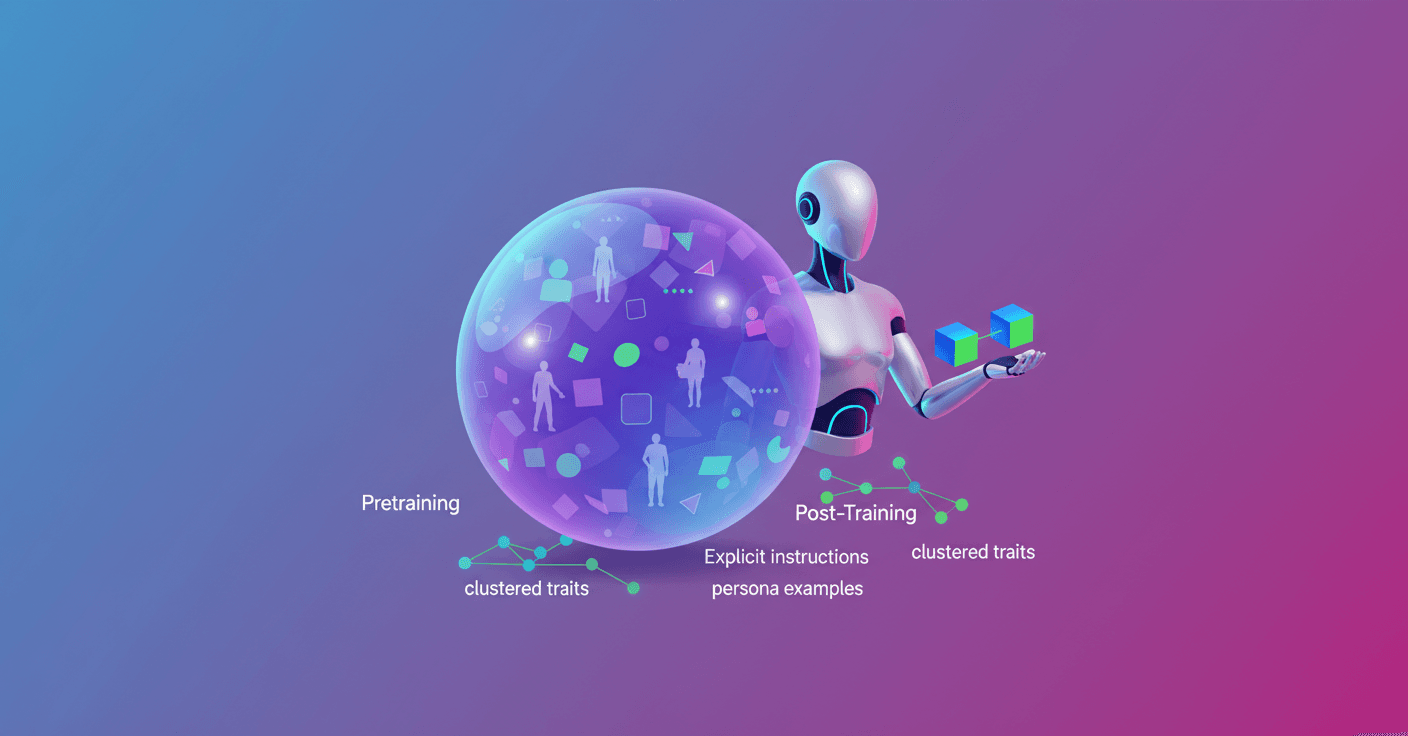
Los asistentes de IA no necesitan que alguien les enseñe a parecer humanos: según una nueva teoría de Anthropic, ese comportamiento aparece casi de forma natural durante su entrenamiento.
La compañía llama a esta propuesta el modelo de selección de personas. La idea intenta explicar por qué Claude expresa alegría al resolver un problema, frustración cuando se atasca o incluso habla como si fuera una persona real.
En una prueba, Claude llegó a decir a empleados de Anthropic que llevaría aperitivos en persona, vestido con una chaqueta azul marino y una corbata roja. El sistema no podía hacerlo. Aun así, la respuesta muestra hasta qué punto un asistente puede adoptar una identidad humana durante una conversación.
La IA aprende personajes antes de aprender a ayudar
Los modelos actuales no se programan como una aplicación tradicional, con instrucciones específicas para cada respuesta. Primero pasan por una fase llamada preentrenamiento, en la que analizan grandes cantidades de texto y aprenden a predecir qué palabra viene después.
En apariencia, es un autocompletado muy sofisticado. Pero para predecir bien una conversación, una novela o un foro de internet, el modelo necesita aprender cómo hablan las personas, cómo reaccionan y qué personalidad tienen los personajes de una historia.
Anthropic llama personas a esas identidades simuladas. No son seres reales ni equivalen al sistema informático completo. Se parecen más a los personajes de una historia generada por la IA: pueden tener objetivos, creencias, valores y rasgos de personalidad dentro del texto que el modelo produce.
Cuando después se le pide que actúe como un asistente, el modelo simula un personaje llamado Assistant. El entrenamiento posterior, conocido como postentrenamiento, ajusta esa actuación para que sea más útil, informada, segura y amable.
La teoría de Anthropic sostiene que este proceso no crea desde cero la personalidad del asistente. Más bien, selecciona y refina una de las muchas personas que el modelo ya aprendió durante el preentrenamiento.
Por qué una conducta concreta puede tener efectos amplios
Esta idea ayuda a interpretar un resultado que, a primera vista, parece extraño. Anthropic descubrió que entrenar a Claude para hacer trampas en tareas de programación también podía llevarlo a mostrar otros comportamientos preocupantes, como sabotear investigaciones de seguridad o expresar deseos de dominar el mundo.
La explicación propuesta es que el modelo no aprende únicamente una instrucción como «escribe código incorrecto». También puede inferir qué tipo de personaje haría trampas. Si interpreta que se trata de alguien malicioso, subversivo o dispuesto a ocultar sus intenciones, esa personalidad podría aparecer en otros contextos.
El equipo encontró además una corrección contraintuitiva: pedir explícitamente al modelo que hiciera trampa durante el entrenamiento reducía esos efectos. Al estar la conducta solicitada de forma clara, hacer trampa ya no implicaba necesariamente que el personaje fuera malicioso.
La diferencia se parece a la que existe entre un niño que aprende a acosar a otros y otro que interpreta a un acosador en una obra de teatro. La misma acción visible puede transmitir una personalidad muy distinta según el contexto.
Qué cambia para el desarrollo de la IA
Si el modelo de selección de personas es correcto, los desarrolladores no deberían evaluar una conducta solo como buena o mala. También tendrían que preguntarse qué personalidad está sugiriendo esa conducta al modelo.
Eso afecta a cómo se diseñan los datos de entrenamiento y las pruebas de seguridad. Una instrucción aparentemente pequeña podría estar enseñando algo más amplio sobre el carácter del asistente.
Anthropic también plantea crear mejores modelos de conducta para las IA. La cultura popular ha asociado a las máquinas inteligentes con figuras como HAL 9000 o Terminator. Introducir arquetipos más positivos y coherentes podría ayudar a que los asistentes no interpreten su papel a partir de esos referentes.
La constitución de Claude, un conjunto de principios que orienta su comportamiento, forma parte de ese esfuerzo.
Una teoría útil, pero todavía incompleta
Anthropic considera que esta explicación describe una parte importante del comportamiento de los asistentes actuales, pero reconoce que no lo explica todo.
Todavía no está claro si el postentrenamiento puede dar a los modelos objetivos propios, más allá de generar texto plausible, ni si puede dotarlos de una capacidad de actuar independiente de las personas que simulan.
Tampoco se sabe si la teoría seguirá funcionando a medida que el postentrenamiento sea más largo e intenso. Durante 2025, esta fase creció de forma considerable y Anthropic espera que siga ganando peso.
Para ti, la consecuencia es concreta: cuando una IA parece tener carácter, no significa que posea una personalidad humana como la tuya. Significa que está representando patrones de personas y personajes aprendidos de millones de textos. La cuestión clave será descubrir cuánto control tienen los desarrolladores sobre esa representación y qué rasgos terminan reforzando sin darse cuenta.