Anthropic actualiza su política de escalado de IA
Anthropic publica la versión 3.0 de su política de escalado responsable y reconoce que medir los riesgos de los modelos avanzados es más difícil de lo previsto. El nuevo marco separa sus compromisos propios de las recomendaciones para toda la industria e introduce hojas de ruta, informes de riesgo periódicos y revisión externa.
Anthropic publicó la versión 3.0 de su política de escalado responsable, el marco voluntario que utiliza para decidir qué medidas de seguridad aplicar cuando sus modelos de IA alcanzan nuevas capacidades. La empresa reconoce que algunas partes del sistema han funcionado, pero que otras dependen de supuestos que ya no encajan con la velocidad de desarrollo actual.
La política original, publicada en septiembre de 2023, clasificaba los modelos en distintos niveles de seguridad, conocidos como ASL. La idea era sencilla: si un modelo superaba cierto umbral de capacidad, Anthropic debía activar protecciones más estrictas.
Por ejemplo, un modelo con capacidades suficientes para ayudar en la creación de armas biológicas exigiría controles adicionales contra el uso malicioso y el robo de sus archivos internos, conocidos como pesos del modelo.
Qué ha cambiado desde 2023
Los modelos actuales ya no se limitan a responder preguntas. Pueden navegar por internet, escribir y ejecutar código, utilizar ordenadores y completar tareas en varios pasos con cierto grado de autonomía. Eso ha creado riesgos que no estaban contemplados cuando Anthropic diseñó su primera política.
La empresa afirma que el marco sí produjo resultados concretos. En mayo de 2025 activó las protecciones de ASL-3 para los modelos relevantes, centradas principalmente en riesgos químicos y biológicos. Entre esas medidas están clasificadores de entrada y salida, sistemas que detectan y bloquean solicitudes o respuestas relacionadas con contenido peligroso.
El enfoque también influyó en otras compañías. OpenAI y Google DeepMind adoptaron marcos parecidos pocos meses después, mientras que algunos principios de estas políticas voluntarias han aparecido en iniciativas regulatorias de California, Nueva York y la Unión Europea.
Pero el sistema tiene un problema central: no siempre está claro cuándo un modelo ha cruzado un umbral de riesgo.
El problema de medir capacidades peligrosas
Anthropic explica que sus modelos ya muestran conocimientos biológicos suficientes para superar muchas pruebas rápidas. Eso impide afirmar que el riesgo sea bajo. Sin embargo, esas mismas pruebas no demuestran por sí solas que el riesgo sea alto.
Los estudios más completos, como los que requieren pruebas en laboratorios reales, tardan tanto que pueden terminar cuando ya existen modelos más potentes. El resultado es una zona de ambigüedad: la compañía puede decidir aplicar precauciones, pero no siempre cuenta con pruebas suficientemente claras para convencer a otras empresas o a los gobiernos de hacer lo mismo.
A esto se suma que la acción gubernamental ha avanzado más despacio que las capacidades de la IA. Anthropic señala que el debate político se ha concentrado en la competitividad y el crecimiento económico, mientras que las medidas de seguridad todavía no han ganado suficiente fuerza a nivel federal en Estados Unidos.
Los niveles superiores de su política también plantean un límite práctico. Algunas protecciones contra modelos muy avanzados podrían ser demasiado difíciles para que una sola empresa las implemente por su cuenta. Anthropic cita un informe de RAND según el cual un nivel de seguridad destinado a proteger los pesos del modelo frente a las instituciones con mayores capacidades cibernéticas “actualmente no es posible” y probablemente requeriría ayuda de organismos de seguridad nacional.
Tres cambios en la nueva política
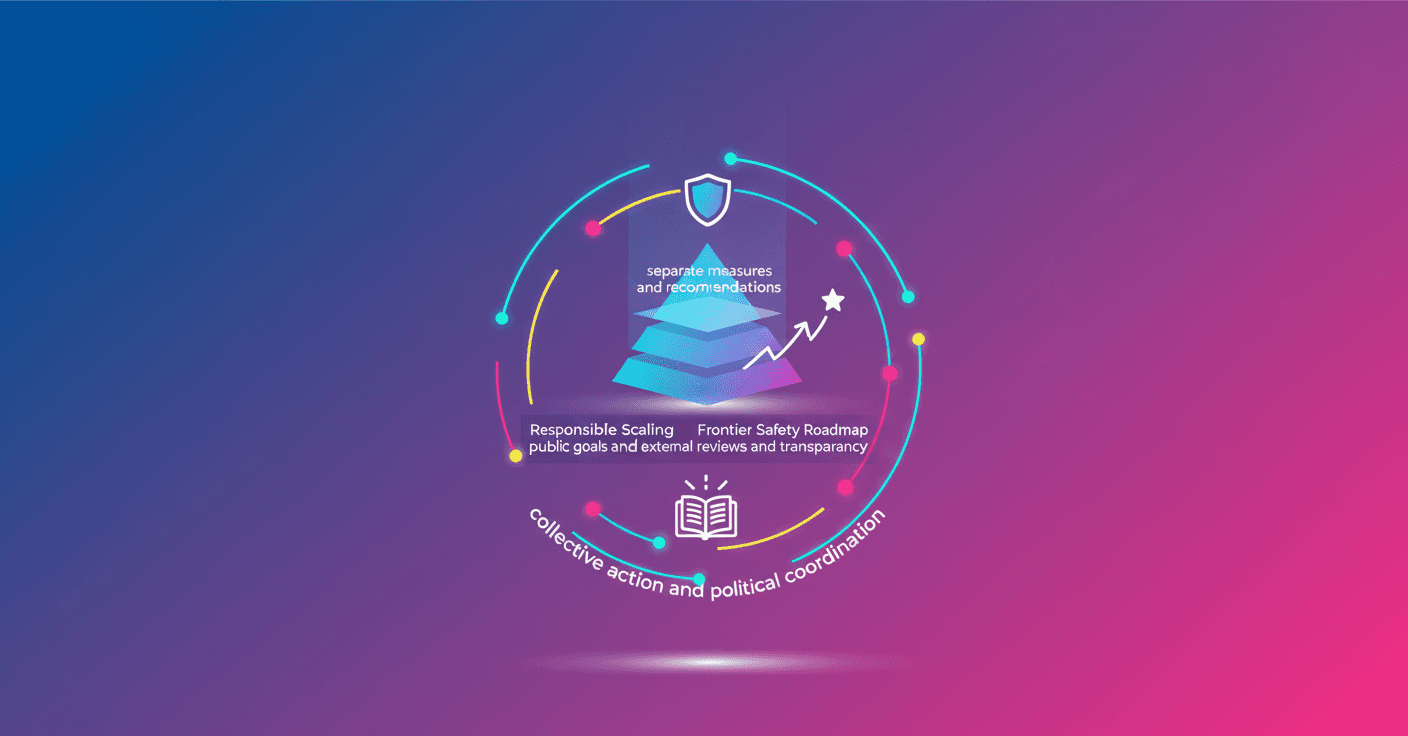
La versión 3.0 reorganiza el marco en tres bloques principales:
- Separación entre compromisos y recomendaciones. Anthropic distinguirá entre las medidas que aplicará independientemente de lo que hagan otras compañías y un mapa más ambicioso de capacidades y protecciones que, según la empresa, debería adoptar toda la industria.
- Una hoja de ruta de seguridad avanzada. La compañía publicará objetivos concretos en seguridad informática, alineación, controles contra el uso indebido y política pública. No serán promesas vinculantes, pero Anthropic informará públicamente de sus avances.
- Informes de riesgo y revisión externa. Cada tres a seis meses publicará informes sobre la seguridad de sus modelos, sus capacidades, las amenazas consideradas y las medidas activas. Algunos datos podrán ocultarse por motivos legales, de privacidad, propiedad intelectual o seguridad pública.
En determinadas circunstancias, expertos externos revisarán esos informes con acceso a versiones sin censura o con pocas partes ocultas. Anthropic ya está realizando pruebas de este proceso, aunque afirma que sus modelos actuales todavía no requieren formalmente una revisión externa.
Qué significa para ti
La actualización no anuncia un nuevo modelo ni una capacidad disponible para los usuarios. Cambia, sobre todo, la manera en que Anthropic promete evaluar y comunicar los riesgos de sus futuros sistemas.
Para quienes utilizan Claude, el efecto directo será limitado a corto plazo. El interés está en otra parte: los informes periódicos podrían permitir comprobar si las medidas de seguridad avanzan al mismo ritmo que las capacidades del modelo, en lugar de depender únicamente de declaraciones generales de la empresa.
Anthropic también reconoce que sus compromisos unilaterales tienen un límite. Para los riesgos más graves, la seguridad puede depender de normas comunes, cooperación entre compañías y participación de los gobiernos. La nueva política intenta hacer visible esa diferencia antes de que los modelos alcancen niveles todavía más difíciles de controlar.