Ai2 presenta Bolmo, modelos de IA que leen bytes
Ai2 presenta Bolmo, una familia de modelos de lenguaje que procesa texto directamente como bytes en lugar de fragmentos de palabras. Bolmo 7B mantiene un rendimiento general cercano a Olmo 3 y mejora casi 20 puntos en pruebas centradas en caracteres, según las evaluaciones de Ai2.
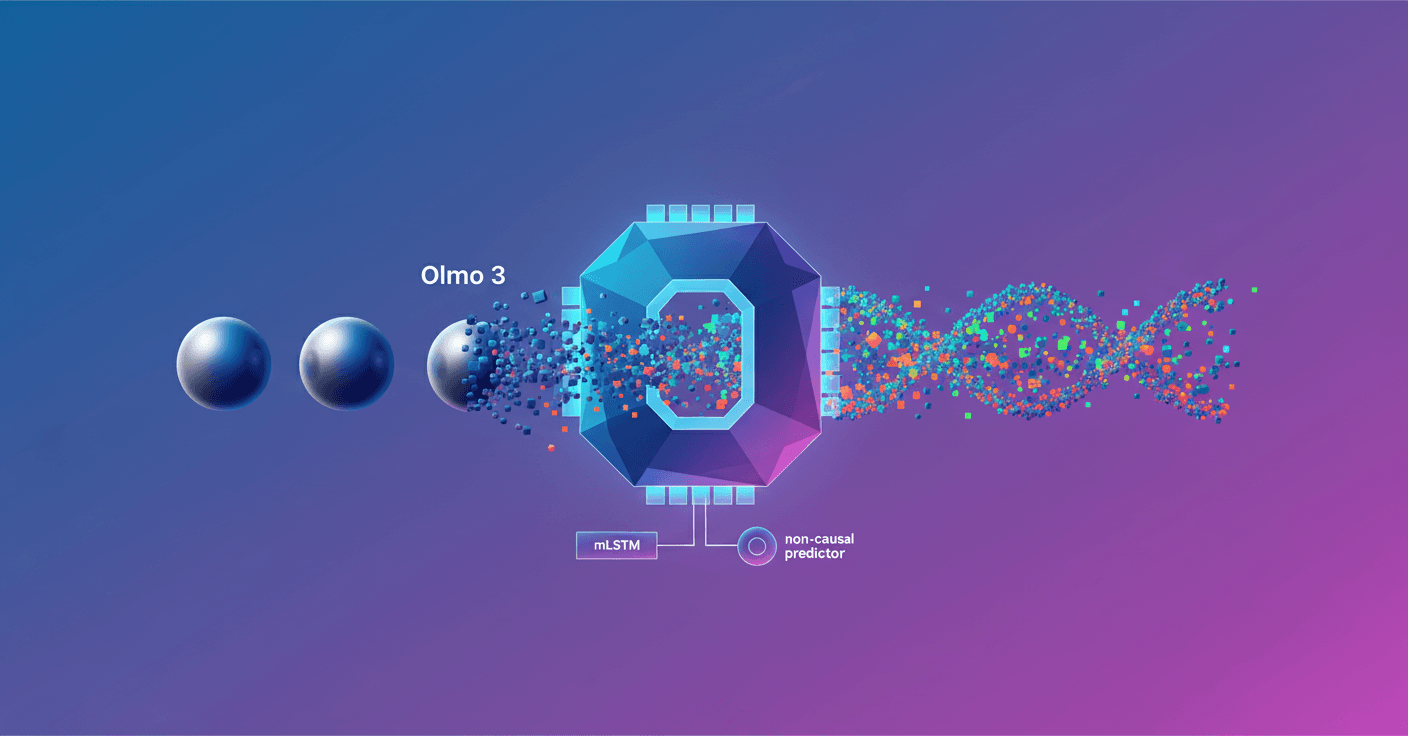
Ai2 ha presentado Bolmo, una familia de modelos de lenguaje que procesa el texto directamente como bytes, las unidades básicas de los archivos digitales, en lugar de dividirlo en fragmentos de palabras. La propuesta busca mejorar la comprensión de caracteres, errores ortográficos, símbolos y textos en varios idiomas sin renunciar al rendimiento de los modelos actuales.
Los modelos de lenguaje suelen trabajar con tokens: fragmentos de palabras como inter, national o ization. Este sistema es eficiente, pero puede fallar con palabras poco comunes, espacios, mezclas de idiomas o tareas que dependen de cada carácter, como revisar una contraseña o generar código con precisión.
Bolmo intenta resolver ese problema sin entrenar un modelo completamente desde cero. Ai2 tomó como base sus modelos abiertos Olmo 3 y los adaptó para que trabajen con bytes. El resultado son dos modelos, Bolmo 7B y Bolmo 1B, que la organización presenta como modelos de bytes completamente abiertos y competitivos frente a alternativas basadas en tokens.
Cómo funciona Bolmo
Cada byte de un texto pasa primero por un codificador local que analiza el contexto cercano. Después, un predictor decide dónde agrupar esos bytes en bloques de longitud variable, llamados patches. Esos bloques llegan al transformador principal, que conserva la arquitectura general de Olmo 3.
Al final, el modelo vuelve a descomponer la información en bytes para predecir el siguiente carácter y decidir el siguiente límite. La diferencia importante es que los límites no son fijos: Bolmo puede agrupar más o menos bytes según la información que contengan.
Esto permite combinar dos ventajas. El modelo conserva la capacidad de un transformador grande entrenado con datos y técnicas ya probadas, pero también puede mirar el texto con un nivel de detalle que los tokens no siempre ofrecen.
Más precisión con caracteres, sin empezar de cero
Entrenar un modelo de bytes desde cero suele ser caro porque debe aprender otra vez buena parte de lo que los modelos de tokens ya dominan. Ai2 eligió un camino distinto.
Primero congeló el transformador de Olmo 3 y entrenó los componentes nuevos con 9.800 millones de tokens, equivalentes aproximadamente a 43.000 millones de bytes. Después desbloqueó todo el modelo y añadió otros 39.300 millones de tokens, unos 173.000 millones de bytes, para que Bolmo aprovechara mejor la información a nivel de carácter.
En las pruebas de Ai2, Bolmo 7B quedó cerca de Olmo 3 7B en evaluaciones generales de matemáticas, ciencia, preguntas y respuestas, código y conocimiento general. En cambio, ganó con claridad en pruebas centradas en caracteres, como CUTE y EXECUTE.
En el conjunto agregado de tareas de caracteres, Bolmo 7B mejoró casi 20 puntos de precisión frente a Olmo 3. Frente a otros modelos de bytes de tamaño parecido, como BLT 7B, TFree-Hat 7B y EvaByte 6.5B, Ai2 afirma que obtuvo el mejor resultado general en código, matemáticas, preguntas de opción múltiple y comprensión de caracteres, aunque quedó ligeramente por debajo de TFree-Hat 7B en GenQA.
¿Es más lento?
Trabajar con bytes puede significar procesar muchas más unidades que trabajar con palabras fragmentadas. Bolmo intenta compensarlo agrupando dinámicamente los bytes.
En las mediciones compartidas por Ai2, Bolmo alcanza alrededor de 125 bytes por segundo, frente a unos 150 bytes por segundo de su modelo basado en tokens con una compresión comparable. La velocidad puede aumentar si el modelo agrupa más bytes en cada bloque, aunque eso implica ajustar el equilibrio entre rapidez y detalle.
Esa compresión funciona como un control graduable. En un modelo tradicional, ampliar el vocabulario puede hacer que la capa que elige el siguiente token se vuelva más pesada. Bolmo puede buscar más eficiencia aumentando el número medio de bytes por bloque, sin tener que rediseñar todo el vocabulario.
Qué cambia para ti
La ventaja no está en que Bolmo vaya a sustituir automáticamente a los chatbots actuales. Su interés está en los casos donde los detalles pequeños importan mucho:
- Revisar ortografía, formatos y cadenas de texto.
- Trabajar con código, símbolos y caracteres poco frecuentes.
- Procesar idiomas y escrituras con menor representación en los vocabularios habituales.
- Manejar texto mal escrito, mezclado o con estructuras inusuales.
- Ajustar la velocidad y el nivel de detalle según la tarea.
Además, Ai2 probó que Bolmo puede heredar capacidades de una versión de Olmo 3 entrenada para seguir instrucciones sin repetir todo el entrenamiento. Mediante una técnica de combinación de pesos, el modelo pasó de 31,1% a 67,4% en IFEval, prácticamente igualando el 66,9% de la versión original de Olmo 3 entrenada para instrucciones.
Eso abre una posibilidad relevante para los modelos abiertos: adaptar un modelo basado en tokens a bytes y, después, reutilizar parte de sus ajustes, adaptadores y mejoras sin reconstruir todo el ecosistema desde cero. Ai2 advierte que esta compatibilidad no está garantizada para cualquier familia de modelos.
Bolmo todavía es una propuesta de investigación, no una prueba de que los bytes sean siempre mejores que los tokens. Lo que aporta es una vía práctica para probarlos con modelos abiertos ya capaces. El siguiente paso será comprobar si este enfoque mantiene sus ventajas al crecer a modelos más grandes, otros idiomas y aplicaciones especializadas.